השגיאה של מודל על השורות שהוא התאמן עליהן אומרת מעט על איך הוא יסתדר עם שורות חדשות. הוא כבר ראה אותן. אז שומרים חלק בצד, מאמנים על השאר, ונותנים ציון על החלק ששמרנו. זו החלוקה לאימון ומבחן, והציון על סט המבחן הוא ההערכה לאיך המודל יתנהג על דאטה שלא ראה.
מה שמקבל פחות תשומת לב הוא שההערכה הזו היא בעצמה מדידה, עם אי־ודאות משלה. הרשימה הזו מודדת את אי־הוודאות הזו ישירות, על דאטה קטן מספיק כדי לנסות כל חלוקה.
ההגדרות
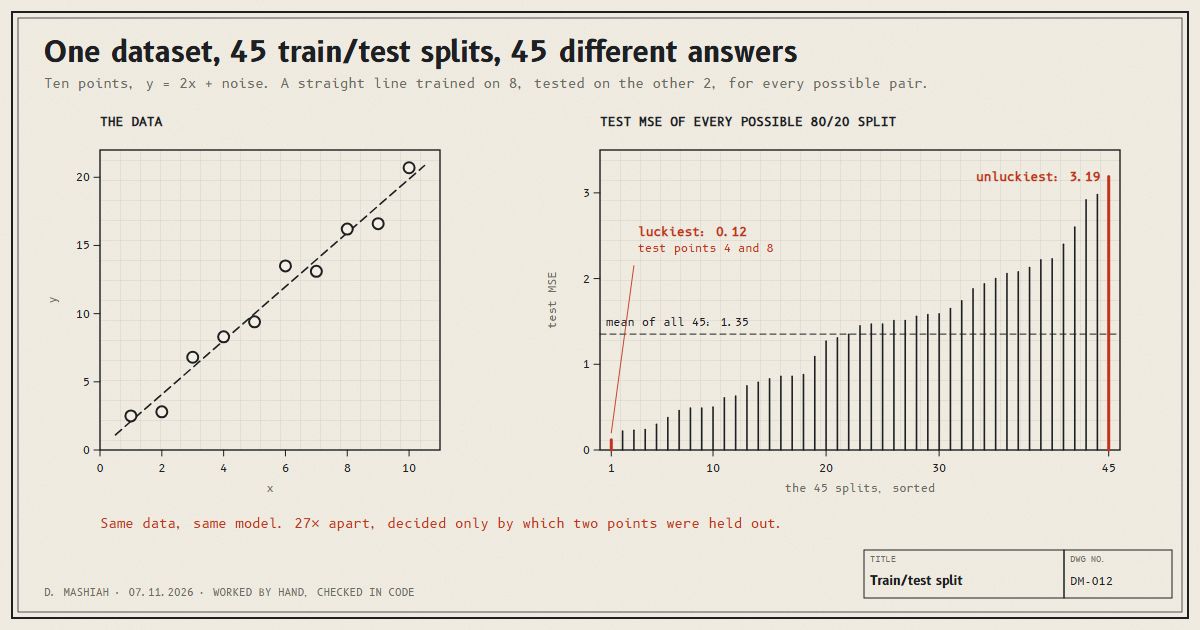
עשר נקודות, x מ־1 עד 10, עם y = 2x ועוד קצת רעש קבוע: y = 2.5, 2.8, 6.8, 8.3, 9.4, 13.5, 13.1, 16.2, 16.6, 20.7. המודל הוא קו ישר שמותאם בריבועים פחותים. הציון הוא שגיאה ריבועית ממוצעת, MSE, על נקודות המבחן.
חלוקת 80/20 מאמנת על 8 נקודות ובודקת על 2. יש 45 דרכים לבחור איזה 2, אז הרצתי את כל ה־45.
מה 45 החלוקות אמרו
| על פני כל 45 החלוקות | MSE במבחן |
|---|---|
| החלוקה הכי מזלית, נקודות מבחן 4 ו־8 | 0.12 |
| חציון | 1.45 |
| ממוצע | 1.35 |
| החלוקה הכי חסרת מזל, נקודות מבחן 6 ו־10 | 3.19 |
המודל לא השתנה והדאטה לא השתנה. הציון זז פי 27 כי שתי נקודות מבחן הן מדגם זעיר, ואם במקרה הן יושבות קרוב לקו או רחוק ממנו, זה מכריע הכול.
לשם השוואה, השגיאה על דאטה האימון עצמו, כשמתאימים את כל עשר הנקודות, היא 0.83. החלוקה המזלית מדווחת שגיאת מבחן נמוכה פי שבעה מזה, מה שהיה נקרא כמו מודל שמצליח יותר על דאטה חדש מאשר על הדאטה שממנו למד. זה לא המצב. לחלוקה היה מזל.
לחפש seed
בקוד, החלוקה נבחרת בדרך כלל לפי seed אקראי. מנסים מודל, הציון מאכזב, משנים את ה־seed, מנסים שוב. שום דבר בזה לא מרגיש כמו רמאות. אבל כשיש 45 תשובות אפשריות שמפוזרות על פני פי 27, לבחור את ה־seed שנותן מספר טוב זה לבחור את התשובה.
הפתרון הוא לקבע את ה־seed לפני שמסתכלים על תוצאה כלשהי ולא לגעת בו, או, עדיף, להפסיק להישען על חלוקה אחת.
דליפת מידע: סט המבחן צריך להישאר לא נראה
החלוקה מודדת משהו רק אם לשורות המבחן אין שום השפעה על האימון. הדרך הנפוצה לשבור את זה היא להכין את הדאטה לפני שמחלקים אותו: לנרמל כל פיצ׳ר לפי הממוצע וסטיית התקן של כל הדאטה, למלא ערכים חסרים מכל העמודה, או לבחור פיצ׳רים לפי כמה הם מתואמים עם המטרה על פני כל השורות. כל אחד מאלה נותן לשורות המבחן להשאיר טביעת אצבע על המודל.
הכלל הוא לחלק קודם, אחר כך להתאים כל שלב הכנה על שורות האימון בלבד, ולהחיל אותו כמו שהוא על שורות המבחן. אותו דבר לשורות שהן לא באמת בלתי תלויות, כמו כמה מדידות מאותה מכונה או מאותו מטופל. אם אחת נופלת באימון והתאומה שלה במבחן, המודל נבחן על משהו שהוא כמעט ראה. המקרה הזה מחושב ברשימה על אימות צולב, שבה אותו מודל מקבל R² של 0.80 או −0.67 בהתאם לזה.
מתי חלוקה אחת מספיקה
הפיזור מגיע מזה שסט המבחן קטן. ממוצע על n נקודות מבחן מתפזר פחות ככל ש־n גדל, בערך כמו 1 / √n, אז סט מבחן גדול פי ארבעה מתפזר בערך חצי. עם מאות אלפי שורות, חלוקה קבועה אחת נותנת מספר יציב, וזה מה שרוב הפרויקטים הגדולים עושים.
עם עשרות או מאות שורות, עדיף שכל שורה תשמש פעם אחת כנקודת מבחן. הממוצע של שגיאת המבחן על כל 45 החלוקות כאן הוא 1.35. השארת אחד בחוץ, שבודקת על כל נקודה בתורה, נותנת 1.32. כל אחד מהם הוא הערכה יציבה בהרבה מכל חלוקת 80/20 בודדת, ואימות צולב k־fold הוא הגרסה המעשית של אותו רעיון.
ובכל שיטה, מדווחים את הפיזור יחד עם הציון, לא רק את הציון. שגיאת מבחן של 1.35 אומרת מעט עד שיודעים שחלוקה אחת לבדה הייתה יכולה להגיד 0.12 או 3.19.
בתחרות אמיתית אותו רעש הכריע דירוגים: קוד זהה קיבל 6.241, 6.259 ו־6.368. זה נמצא ברשימה על איך הוולידציה שלי דירגה חמישה מודלים הפוך.