R², מקדם הקביעה, הוא השוואה מול קו בסיס. קו הבסיס הוא החיזוי הכי טיפשי שאפשר: הממוצע של הנתונים, לכל נקודה. R² שואל איזה חלק מהשגיאה הריבועית של קו הבסיס המודל שלכם מוריד.
הנוסחה, עם מספרים
שמונה נקודות, x מ־1 עד 8, עם y = 4.0, 3.5, 8.1, 6.9, 12.4, 10.2, 15.8, 14.1. הממוצע של y הוא 9.375.
SS_tot, סכום הריבועים הכולל, הוא ההחטאה הריבועית של קו הבסיס: Σ (y − ממוצע)². כאן הוא 144.6.
SS_res, סכום ריבועי השאריות, הוא ההחטאה הריבועית של המודל שלכם. קו ריבועים פחותים דרך הנקודות האלה הוא y = 1.66 + 1.71x, וההחטאות הריבועיות שלו מסתכמות ב־21.2.
R² = 1 − SS_res / SS_tot = 1 − 21.2 / 144.6 = 0.854
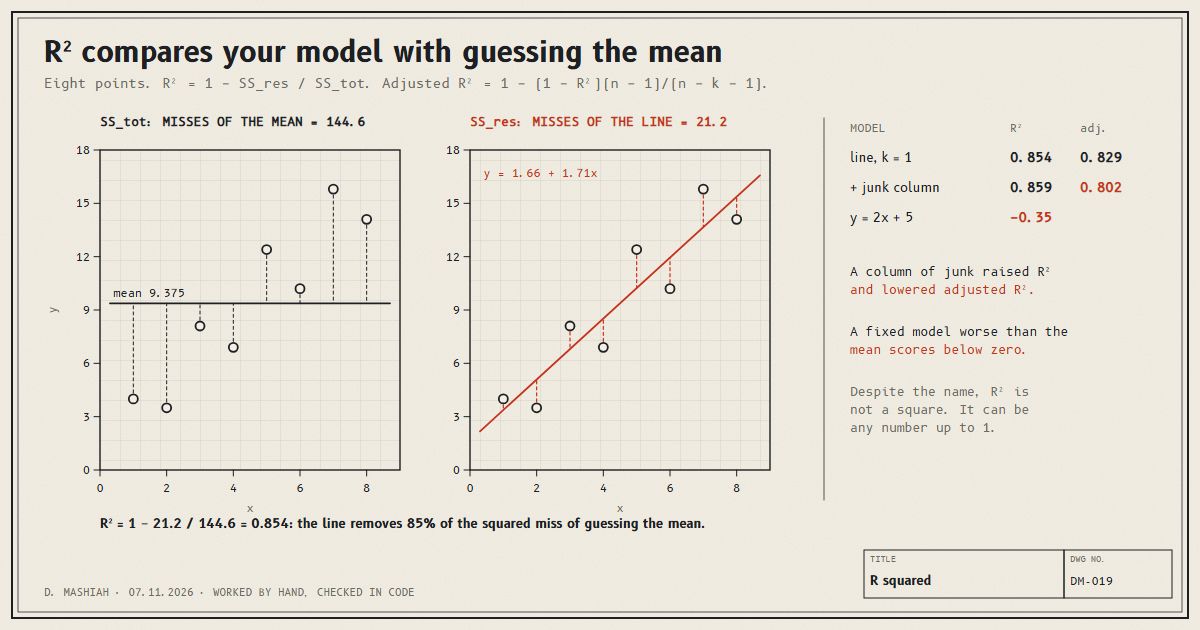
אז הקו מוריד 85 אחוז מהשגיאה הריבועית של ניחוש הממוצע. זה כל מה ש־R² אומר. הוא לא אומר שהחיזויים בתוך 15 אחוז, ולא שהקו הוא המודל הנכון, ולא שהוא יצליח באותה מידה על נתונים חדשים.
R² יכול להיות שלילי
השם רומז על ריבוע, אז הוא לא יכול לרדת מתחת לאפס. הוא יכול. ניקח מודל שלא הותאם לנקודות האלה, נגיד y = 2x + 5, מדאטה אחר. ההחטאות הריבועיות שלו כאן מסתכמות ב־195.7, יותר מ־144.6 של קו הבסיס:
R² = 1 − 195.7 / 144.6 = −0.35
R² שלילי אומר שהמודל גרוע מלחזות את הממוצע בכל פעם. זה לא יכול לקרות לקו ריבועים פחותים שמקבל ציון על נתוני האימון שלו, כי הממוצע הוא אחד הקווים שהוא יכול היה לבחור. זה קורה כל הזמן על נתוני מבחן, ושם זה חשוב. זה מחושב ככשל אמיתי ברשימה על כשל מחוץ להתפלגות, וברשימה על אימות צולב, שבה אותו מודל מקבל 0.80 או 0.67− לפי איך שחילקו את הנתונים.
עוד קלטים תמיד עוזרים, על הנייר
מוסיפים למודל קלט שני: עמודה z = 3, 7, 1, 5, 8, 2, 6, 4, שהיא פשוט המספרים 1 עד 8 מעורבבים ואין לה שום קשר ל־y. מתאימים y = a + b·x + c·z בריבועים פחותים.
R² עולה, מ־0.854 ל־0.859. הוא תמיד עולה, או נשאר אותו דבר, כשמוסיפים קלט להתאמת ריבועים פחותים על נתוני האימון שלה, כי ההתאמה תמיד יכולה לקבוע את המקדם החדש לאפס ולא להיות גרועה יותר. עם מספיק עמודות זבל, R² מטפס לכיוון 1 על נתונים שהמודל פשוט שינן.
R² מתוקנן
R² מתוקנן גובה מחיר על כל קלט. עם n נקודות ו־k קלטים:
adjusted R² = 1 − (1 − R²) · (n − 1) / (n − k − 1)
| מודל | k | R² | R² מתוקנן |
|---|---|---|---|
| קו ב־x | 1 | 0.854 | 1 − 0.146 × 7 / 6 = 0.829 |
| x ועוד עמודת הזבל z | 2 | 0.859 | 1 − 0.141 × 7 / 5 = 0.802 |
עמודת הזבל העלתה את R² והורידה את R² המתוקנן. מקדם הקנס (n − 1) / (n − k − 1) גדל מ־7/6 ל־7/5, והשיפור הקטן בהתאמה לא הספיק כדי לשלם עליו. קלט צריך להרוויח את המקום שלו.
אבל R² מתוקנן הוא תיקון על נתוני אימון, לא תחליף לבדיקה. הבדיקה הכנה היא עדיין הציון על נתונים שהמודל לא ראה, מסט מבחן ששמרו בצד או מאימות צולב.
לקרוא R² בפועל
- הוא יחסי לפיזור של הנתונים. אותה שגיאת מודל נותנת R² גבוה על נתונים שמשתנים הרבה ונמוך על נתונים שכמעט לא משתנים. משווים R² רק בין מודלים על אותם נתונים.
- הוא לא אומר כלום על גודל ביחידות. בשביל זה מדווחים לידו שגיאה ביחידות של המטרה, כמו RMSE או MAE.
- R² על נתוני אימון מחמיא. תמיד אומרים על איזה נתונים הוא חושב.
- מתחת לאפס זה לא באג. זה המודל עושה גרוע מהממוצע, וכדאי לדעת את זה.