צריך לתת למודל ציון על נתונים שהוא לא אומן עליהם, אחרת הציון מודד רק זיכרון. אפשר להפריד סט מבחן אחד, אבל כשיש מעט נתונים הציון תלוי מאוד באילו שורות נפלו בו. אימות צולב פותר את זה בכך שכל שורה נבדקת פעם אחת בדיוק.
יש לו גם כשל שלא מופיע במספר. נתקלתי בו במחקר שלי, וכתבתי על זה ברשימה על מודל שקיבל ציון מושלם. כאן שני החלקים מחושבים ביד.
איך עובד אימות צולב ב־k קיפולים
מחלקים את הנתונים ל־k חלקים שווים, שנקראים קיפולים (folds). מאמנים על k − 1 מהם ובודקים על זה שנשאר בחוץ. חוזרים על זה k פעמים, כך שכל קיפול הוא סט המבחן פעם אחת, ומאחדים את התוצאות לציון אחד.
כל שורה משמשת לבדיקה פעם אחת ולאימון k − 1 פעמים. הבחירות הנפוצות הן 5 ו־10 קיפולים. כש־k שווה למספר השורות, זה נקרא leave-one-out.
שש נקודות, שלושה קיפולים
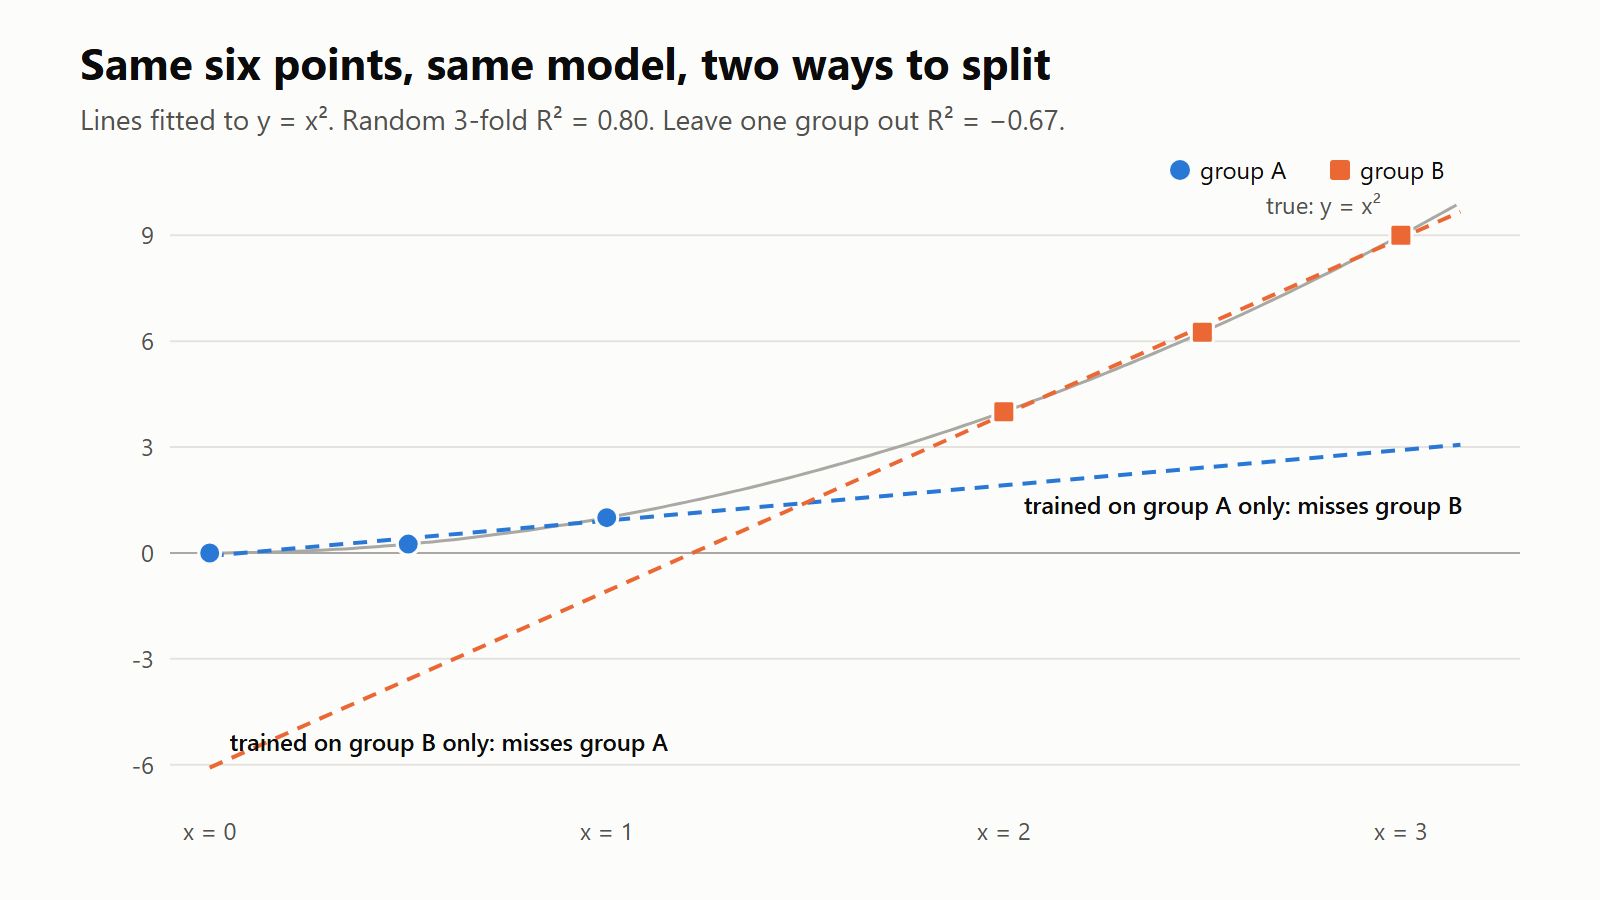
הקשר האמיתי הוא y = x², ויש שש מדידות בשתי קבוצות. קבוצה A: x = 0, 0.5, 1. קבוצה B: x = 2, 2.5, 3. המודל הוא קו ישר שמותאם בשיטת הריבועים הפחותים, והציון הוא R², שבו 1 פירושו מושלם ו־0 פירושו לא יותר טוב מלענות תמיד עם הממוצע.
אימות צולב רגיל בשלושה קיפולים, כשהשורות מחולקות בלי להתחשב בקבוצה: בקיפול 1 נמצאים x = 0 ו־2.5, בקיפול 2 0.5 ו־3, ובקיפול 3 1 ו־2. כל קיפול מערבב נקודה אחת מכל קבוצה.
| קיפול המבחן | הקו שהותאם על הארבע האחרות | תחזיות (ערך אמיתי) |
|---|---|---|
| x = 0, 2.5 | y = 3.517x − 2.153 | −2.15 (0), 6.64 (6.25) |
| x = 0.5, 3 | y = 2.483x − 0.602 | 0.64 (0.25), 6.85 (9) |
| x = 1, 2 | y = 3.000x − 0.625 | 2.38 (1), 5.38 (4) |
כשמאחדים את שש התחזיות, השגיאה הריבועית הממוצעת היא 2.23 ו־R² הוא 0.80. (איך שני הציונים האלה קשורים, ומתי עדיף RMSE או MAE, מוסבר ברשימה על מדדי שגיאה.) קו ישר דרך עקומה, ואימות צולב קורא לזה מודל סביר.
אותו מודל, בחלוקה לפי קבוצות
עכשיו מחלקים לפי קבוצה: מאמנים על קבוצה A ובודקים על קבוצה B, ואז הפוך. זה group k-fold, וכשיש קבוצה אחת בכל קיפול זה נקרא leave-one-group-out.
באימון על קבוצה B הקו הוא y = 5x − 6.083. על קבוצה A הוא חוזה −6.08, −3.58, −1.08, מול ערכים אמיתיים של 0, 0.25 ו־1. באימון על קבוצה A הקו הוא y = x − 1/12. על קבוצה B הוא חוזה 1.92, 2.42 ו־2.92, מול 4, 6.25 ו־9.
השגיאה הריבועית הממוצעת עכשיו היא 18.68 ו־R² הוא −0.67: גרוע יותר מלהתעלם מ־x לגמרי. אותן שש נקודות, אותו מודל. השינוי היחיד הוא אילו נקודות הורשו לשבת יחד באותו קיפול.
למה הקיפולים האקראיים החמיאו לו
בקיפולים האקראיים, לכל נקודת מבחן היו שכנות מהקבוצה שלה בסט האימון. המודל אף פעם לא נדרש להגיע למשהו חדש. הוא רק היה צריך למלא פערים בין נקודות שכבר ראה, וקו ישר ממלא פערים קטנים בעקומה די טוב.
זה הכלל הכללי. אימות צולב מודד ביצועים על נתונים שדומים לקיפולי המבחן. אם הקיפולים מערבבים קבוצות שלא יתערבבו בשימוש אמיתי, הציון עונה על שאלה שאף אחד לא שואל.
איך זה נראה במחקר שלי
אימנתי מודלים לחזות את הקשיחות של לוחות מתכת עם תבניות של חורים. רשת שאומנה על חורים עגולים קיבלה ציון כמעט מושלם על תאים עם חורים עגולים שהיא לא ראתה. באימון על משפחה אחת ובדיקה על אחרת, 20 מתוך 30 הצירופים קיבלו ציון מתחת לאפס.
חלוקה לפי שורות הייתה משאירה את הציון הכמעט מושלם. חלוקה לפי משפחה, המקבילה לחלוקה לפי קבוצות למעלה, הראתה שהמודל למד את המשפחות שראה ולא איך קשיחות עובדת. הגרסה המחושבת של הקריסה הזו נמצאת ברשימה על כשל מחוץ להתפלגות.
איך בוחרים חלוקה
שואלים איך ייראה מקרה חדש בשימוש, ומתאימים את הקיפולים לזה. כמה מדידות מאותו מטופל, מכונה, לקוח או משפחת תכנון צריכות להיות באותו קיפול, וזה מה ש־GroupKFold ו־LeaveOneGroupOut עושים ב־scikit-learn. נתונים לפי סדר זמן צריכים קיפולים שמתאמנים על העבר ונבדקים על העתיד, כמו TimeSeriesSplit, כי חלוקה אקראית נותנת למודל לראות את מחר.
כשהחלוקה לקבוצות לא ברורה, מריצים את שתי החלוקות. פער גדול ביניהן הוא לא רעש. זה הגודל של מה שהמודל שינן.