התחרות הייתה ROGII Wellbore Geology Prediction, תחרות בינלאומית בלמידת מכונה. כל באר נפט אופקית מגיעה עם בערך 700 הרגל הראשונות שלה מתויגות, והמשימה היא לחזות גודל דמוי עומק, עובי אנכי אמיתי, לאורך 4,900 הרגל שנותרו. הציון הוא שורש השגיאה הריבועית הממוצעת ברגל, על כל השורות של כל הבארות הנסתרות יחד.
סיימתי במקום 463 מתוך בערך 5,900 קבוצות, מדליית ארד. במהלך התחרות ניהלתי תיעוד שוטף של כל ניסוי, והחלק ששווה לפרסם הוא מה שהתיעוד הזה מדד על המספרים שלפיהם קיבלתי החלטות. כל אחת מהמלכודות האלה כללית, ולכל אחת יש מקבילה ישירה בחיזוי לתפעול.
חצי מהציון כבר היה פתור
בניתי על מחברת ציבורית. היא כללה שגרה שפתרה כל באר מבחן נסתרת שה־ID שלה הופיע גם בנתוני האימון, בדיוק של בערך 0.01 רגל. זו דליפה בנתוני התחרות, וכל עותק של המחברת הזו ירש אותה, כולל שלי.
מציון הוולידציה של המחברת עצמה ומהציון הראשון שלה בלוח, בערך 53.7 אחוז מהשורות המדורגות נענו על ידי הדליפה הזו. אז לוח התוצאות מדד את המודל שלי רק על החצי השני, והשניים היו קשורים במקדם קבוע: לוח ≈ 0.68 × ולידציה. זה גם אומר ששינוי יכול היה להיראות קטן בלוח וגדול בוולידציה, או להפך, תלוי באילו בארות הוא נגע.
הוולידציה דירגה חמש גרסאות הפוך
לקראת סוף התחרות הגשתי חמש גרסאות באותו יום. הן נבדלו במספר אחד: החלק בשקלול הסופי שניתן למודל מערום נלמד, מ־0.30 עד 0.50. הגשה של כל החמש באותו יום הוציאה מההשוואה כל סחיפה בין ימים.
| חלק ה־ridge | שינוי בוולידציה (נמוך יותר טוב) | RMSE בלוח התוצאות (נמוך יותר טוב) |
|---|---|---|
| 0.30 | +0.056 | 6.243 |
| 0.35 | −0.015 | 6.368 |
| 0.40 | −0.069 | 6.321 |
| 0.45 | −0.106 | 6.496 |
| 0.50 | −0.122 | 6.949 |
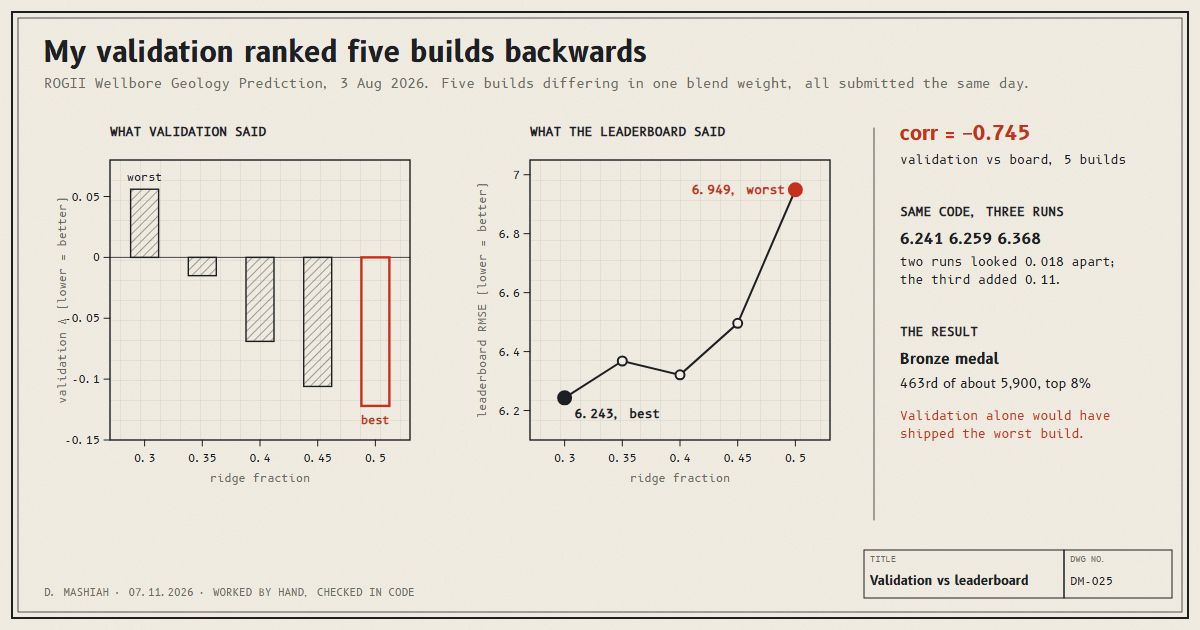
המתאם בין הוולידציה ללוח על פני החמש הוא 0.745−. הגרסה שהוולידציה אהבה הכי הרבה, 0.50, קיבלה את הגרוע ביותר, 6.949. זו שהיא אהבה הכי פחות, 0.30, קיבלה את הטוב ביותר, 6.243. רק שתי האמצעיות מחליפות מקום. זה לא היה רעש סביב קשר אמיתי. בהגדרה הספציפית הזו, הוולידציה הצביעה לכיוון הלא נכון.
הסיבה היא סוג המספר שכוונן. המשקל קבע כמה לסמוך על מודל שנלמד על פני כל הבארות לעומת מודל שהותאם לכל באר בנפרד. ולידציה מחוץ לקפל עדיין נותנת למודל הנלמד ליהנות מבארות שדומות לבאר שהוחזקה בצד, אז הוולידציה ממשיכה לתגמל אותו. ההסבר הכי טוב שיש לי הוא שהבארות הנסתרות לא נתנו את היתרון הזה באותה מידה, אבל אף פעם לא הוכחתי את זה. הכלל הקבוע שלי אחרי זה היה לעולם לא לתת לוולידציה לבחור את המשקל הזה.
קוד זהה הוא לא זהה
המודל היה מסנן חלקיקים, שרץ עם הרבה זרעים אקראיים. הגשתי את אותו קוד בדיוק, באותה גרסה, שלוש פעמים. הוא קיבל 6.241 ו־6.259, ואז 6.368.
אחרי שתי הרצות הפיזור נראה כמו 0.018, ויום שלם שפטתי כל השוואה מולו. ההרצה השלישית הראתה סטיית תקן של בערך 0.07. שתי הרצות לא יכולות לאמוד פיזור. כמה החלטות שקיבלתי באותו יום התייחסו להבדלים של 0.02 עד 0.05 כאמיתיים, והם היו בתוך הרעש.
כשנשארות מעט הגשות, מפתה להריץ שוב את התצורה הכי טובה ולשמור את התוצאה הכי טובה, מתוך הנימוק שהרצה אחת מייצרת את החיזויים גם לחלק הציבורי וגם לחלק הנסתר של סט המבחן, אז הרצה טובה טובה בשניהם. זה נכון רק בחלקו. בחירת הטובה מכמה הרצות רועשות לפי הציון הציבורי שלה בוחרת גם את חלק המזל ששייך לחלוקה הציבורית, והחלק הזה לא עובר לדירוג הסופי.
טועה בביטחון
השגיאה לא הייתה מפוזרת באופן שווה. 10 האחוזים הגרועים של הבארות החזיקו 60.7 אחוז מסך השגיאה הריבועית, ובגרועות שבהן בערך 90 אחוז מהשגיאה היו היסט קבוע: למודל הייתה הצורה הנכונה בעומק הלא נכון.
באר אחת קיבלה RMSE של 39.85 רגל בזמן ש־128 הזרעים האקראיים שלה הסכימו זה עם זה בטווח של 1.16 רגל. הזרעים היו תמימי דעים, וטעו. ניסיתי ארבע דרכים נפרדות לזהות מראש את הבארות הגרועות, כולל חוסר ההסכמה בין הזרעים, ואף אחת לא עבדה מספיק טוב כדי להשתמש בה. הסכמה בין הרצות של אותו מודל היא לא ראיה שהמודל צודק.
ולידציה שדולפת דרך שכנים
חלק מהתוספות שלי חזו באר מתוך בארות קרובות באותה קבוצה גאולוגית. בוולידציה של השארת באר אחת בחוץ, השכנים של הבאר שהוחזקה בצד נשארים בנתוני האימון, אז לתוספות האלה תמיד היו שכנים טובים ללוות מהם. כשחילקתי את בארות האימון לפי כמה שכנים מאותה קבוצה היו להן, המודלים מבוססי השכנים היו גרועים פי 1.8 על בארות בלי שכנים, לעומת פי 1.25 במודל שלא השתמש בשכנים בכלל.
אם הבארות הנסתרות הגיעו מקבוצות שלמות שהוחזקו בצד יחד, המודלים האלה היו פוגשים את המקרה העני בשכנים בכל באר מבחן. זה היה מסביר למה הם עברו כל כך גרוע. זו השערה: את המבחן שהיה מאשר אותה, ולידציה עם קבוצות שלמות בצד, לא סיימתי לפני הדדליין.
מה זה אומר מחוץ לגאולוגיה
מחליפים בארות בחנויות, במוצרים או במסלולי משלוח, ולכל אחד מאלה יש מקבילה ישירה בחיזוי לתפעול.
- לבדוק בדרך שבה המודל ישמש. אם חנויות או מוצרים חדשים מגיעים בלי היסטוריה, מחזיקים בצד קבוצות שלמות בוולידציה, לא שורות בודדות. אחרת פריטים קשורים דולפים לאימון והוולידציה מחמיאה למודל. הרשימה על אימות צולב מראה את אותו אפקט על שש נקודות.
- למדוד קודם את רצפת הרעש. מריצים את אותה תצורה בדיוק לפחות שלוש פעמים לפני שמשווים משהו. הבדל קטן מהפיזור הזה הוא לא תוצאה. חלוקת מבחן אחת יכולה להזיז ציון פי 27.
- לא לבחור לפי ציון רועש. בחירת הטובה מכמה הרצות, זרעים או תצורות לפי מספר אחד בוחרת גם את המזל שלה.
- להסתכל על הישויות הגרועות, לא על הממוצע. עשירית מהבארות החזיקה את רוב השגיאה. אותה בדיקה, לפי מוצר או לפי חנות, שייכת ליד כל שגיאה ממוצעת שתחזית מדווחת.
- כשהוולידציה והמציאות לא מסכימות, להאמין למציאות. ה־0.745− נראה רק כי הגשתי חמש גרסאות ביום אחד במקום לסמוך על הוולידציה בכל החמש.
זו אותה שאלה שהמחקר שלי שואל על מודלים של למידת מכונה בהנדסה: לא כמה טוב מודל מקבל ציון איפה שנמדד, אלא האם הציון הזה שורד איפה שישתמשו בו.
מאז ארזתי את הבדיקות האלה כ־forelint, ספריית Python בקוד פתוח: חלוקות שמודעות לדליפה, רצפת הרעש, מבחני השוואה בין מודלים על פני הרבה סדרות, ובדיקה לפי פריט של הטיה ושגיאה. היא מותקנת עם pip install forelint ושמורה בארכיון עם DOI, 10.5281/zenodo.24044927.