הדרך המקובלת לבחור תחזית היא להשוות מספר שגיאה אחד לכל מודל ולבחור את הקטן. הרשימה הזו מראה, על נתוני קמעונאות אמיתיים, למה המספר הזה לבדו יכול להצביע לכיוון הלא נכון לרוב הקטלוג. כל מה שכאן נמדד עם forelint, ספריית הקוד הפתוח שכתבתי לבדיקת בדיקות חיזוי, והסקריפט שמייצר כל מספר נמצא במאגר שלה.
ההגדרות
הנתונים הם סט התחרות הציבורי M5: מכירות יומיות ביחידות מוולמארט. לקחתי חנות אחת, CA_1, ומחלקה אחת, FOODS_3: 823 פריטים. כל תחזית מכסה את 28 הימים הבאים, והבדיקה חוזרת עליה בעשר נקודות חיזוי בהפרש של 28 ימים, כך שעשר התחזיות לא חופפות וכל השוואה נשענת על עשר תוצאות נפרדות.
שתי תחזיות מתחרות. אחת היא מודל gradient boosting מ־scikit-learn, שאומן על כל הפריטים יחד, עם שישה פיצ׳רים: הפריט, היום בשבוע, המכירות 28 ו־35 ימים קודם, וממוצעים של 7 ו־28 ימים שלהן. הוא פשוט בכוונה. השנייה היא ממוצע נע של 28 ימים: המכירות היומיות הממוצעות של כל פריט בארבעת השבועות האחרונים שלו, שחוזרות קדימה.
בסך הכול
בשגיאה מוחלטת המודל גרוע יותר. ה־MAE שלו היה 1.742 מול 1.676 של הממוצע הנע, ערך מוסף של 3.9− אחוז, והוא היה הגרוע מבין השניים ב־58 אחוז מהפריטים.
בשגיאה ריבועית הוא נראה טוב קצת יותר: RMSE של 3.44 מול 3.51. אבל מבחן Diebold-Mariano על פני עשר נקודות החיזוי נותן p = 0.20, אז ההבדל הזה לא מבוסס. שגיאה ריבועית נותנת משקל כבד להחטאות גדולות, והחטאות גדולות קורות בפריטים שנמכרים הרבה; הרשימה על RMSE מול MAE מחשבת למה השניים יכולים לא להסכים.
לפי סוג ביקוש
הסיווג של Syntetos ו־Boylan ממיין כל פריט לפי כמה פעמים הוא נמכר וכמה גודל המכירה משתנה, לפי ההיסטוריה שלו לפני התחזית הראשונה: יציב, לא סדיר, לסירוגין או מקוטע. מפרקים את אותה בדיקה לפי סוג, בשגיאה מוחלטת:
| סוג ביקוש | פריטים | ערך מוסף מול הממוצע הנע | פריטים שבהם המודל גרוע יותר |
|---|---|---|---|
| יציב | 152 | +5.0% | 23% |
| לא סדיר | 33 | +1.4% | 33% |
| לסירוגין | 463 | −10.5% | 68% |
| מקוטע | 171 | −9.2% | 69% |
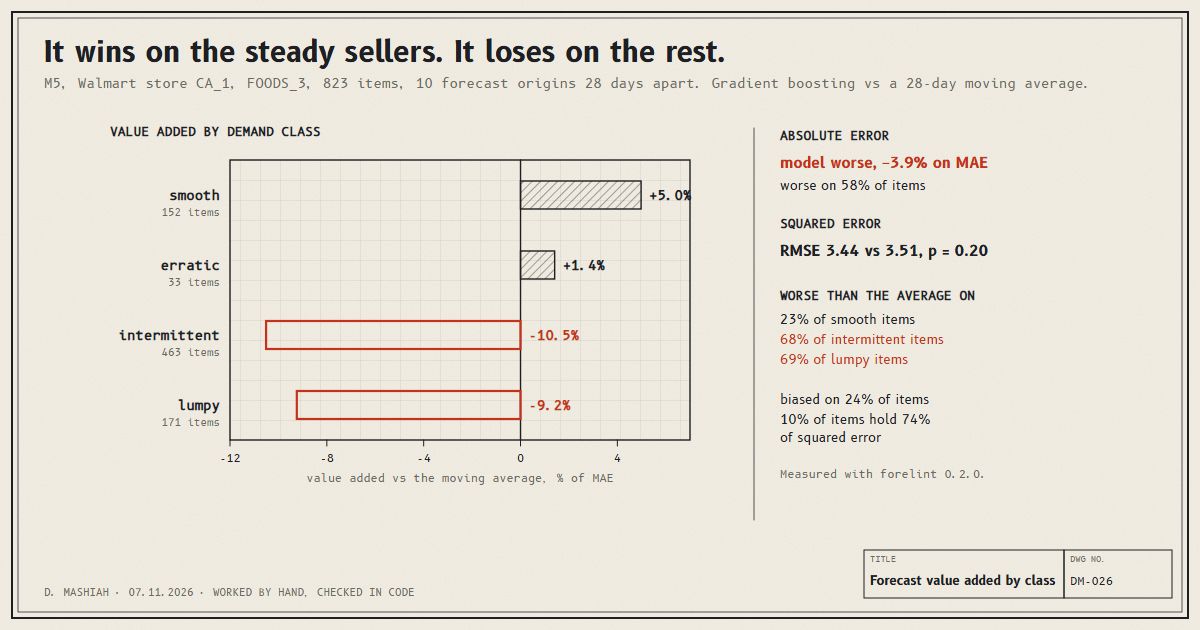
המודל מנצח על 152 הפריטים היציבים ומפסיד על 463 הפריטים לסירוגין ו־171 המקוטעים, שיחד הם 77 אחוז מהחנות. בבערך שני שלישים מהפריטים לסירוגין והמקוטעים, הממוצע הנע היה התחזית הטובה יותר.
זה משנה את ההחלטה. המספר הכולל אומר שהממוצע הנע טוב קצת יותר. הפירוק אומר להשתמש במודל לפריטים היציבים, שם הוא טוב יותר, ובתחזית פשוטה יותר או בשיטה שנבנתה לביקוש לסירוגין לשאר. מודל אחד לכל הפריטים הוא הבחירה שהמספר הכולל מסתיר.
עוד שני דברים ששווה לדעת
הטיה, פריט אחרי פריט. על פני כל החנות ההטיה של המודל הייתה קטנה, 0.6− אחוז מהמכירות. אבל השגיאה הממוצעת שלו הייתה שונה מאפס באופן מובהק ב־24 אחוז מהפריטים, מול פחות מאחוז אחד לממוצע הנע: גבוה מדי בחלק מהפריטים ונמוך מדי באחרים, ומתקזז בסך הכול. הטיה ברמת הפריט היא מה שהופך למדפים ריקים ולעודפי מלאי, כמו שהרשימה על הטיית תחזית מחשבת.
ריכוז. 82 הפריטים עם השגיאה הגדולה ביותר, עשירית מהחנות, החזיקו 74 אחוז מהשגיאה הריבועית של המודל. שיפור הציון בשגיאה ריבועית הוא בעיקר תיקון של הרשימה הזו, והבדיקה נותנת את שמות הפריטים.
מה הייתי בודק בכל תחזית
- ערך מוסף מול קו בסיס פשוט, במדד השגיאה שמתאים למחיר של החטאה.
- אותה השוואה לפי סוג ביקוש. פריטים יציבים ופריטים לסירוגין מתגמלים שיטות שונות, וממוצע אחד מערבב אותם.
- האם הבדל אמיתי: מבחן Diebold-Mariano או קבוצת אמון של מודלים על פני כמה נקודות חיזוי שהחלונות שלהן לא חופפים. הימים של תחזית אחת לא בלתי תלויים, וחלונות חופפים חולקים ימי יעד.
- הטיה לפי פריט, לא רק בסך הכול, ואילו פריטים נושאים את השגיאה.
forelint עושה את ארבעתם בקריאה אחת, על טבלת הבדיקה שרוב קוד החיזוי כבר מייצר. היא מותקנת עם pip install forelint. סקריפט ה־M5 המלא נמצא במאגר שלה, והסיפור של איך הספרייה התחילה נמצא ברשימה על איך הוולידציה שלי דירגה חמישה מודלים הפוך.
עודכן ב־8 בנובמבר 2026: נמדד מחדש עם forelint 0.2.0 בעשר נקודות חיזוי שהחלונות שלהן לא חופפים. גרסאות קודמות של הרשימה השתמשו בנקודת חיזוי אחת, ואחר כך בנקודות חופפות, ואף אחת מהן לא תומכת במבחן מובהקות תקף.